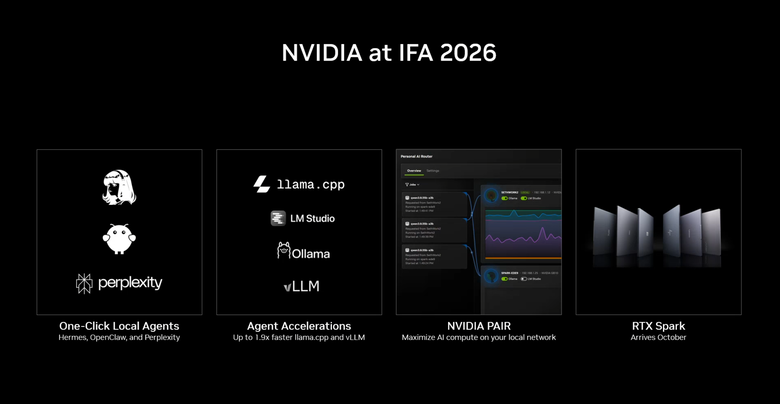
這次 NVIDIA 在 IFA 發表的主要重點,包括對地端 AI 代理的一鍵設定設計、加速執行 AI 代理的效能,推出 NVIDIA PAIR 組織代理設計以及預告 RTX Spark 在 10 月登場的消息。
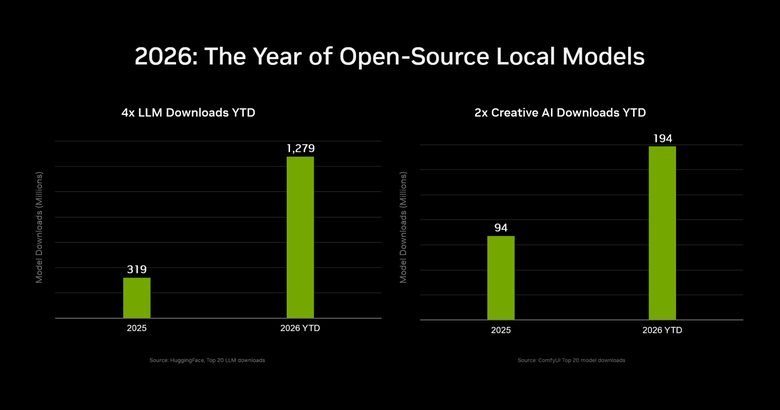
首先來看地端 AI 的部分,NVIDIA 在簡報中提到,在隱私/使用方便性以及成本的考量下,地端 AI 的使用量越來越大,左邊是在 Hugging Face 上排名前 20 的大語言模型下載量,今年到現在為止已經來到了 13 億次,是去年的 4 倍,而生成式 AI 模型也是一樣,以 Comfy UI 來說,今年在 Hugging Face 的下載量也已經是去年的 2 倍,人們已經在地端 AI 上進行各項的日常工作。
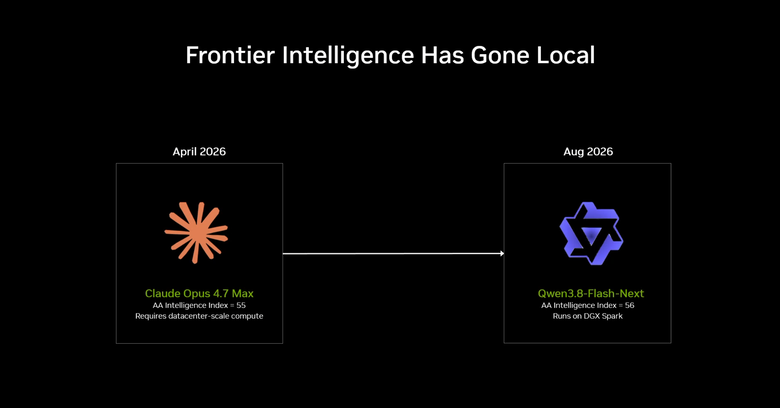
而先進的前沿 LLM 模型也很快的向地端推進,舉例來說,在 4 月份推出的 Claude Opus 4.7 被認為是在 Coding 上面相當強大的雲端前沿模型,但是僅在 4 個月後,就已經可以看到可以在 DGX Station 這樣單一節點上運作的地端模型,像是智譜的 GLM 5.3 或是阿里的 QWen 3.8 Flash-Netx 等等
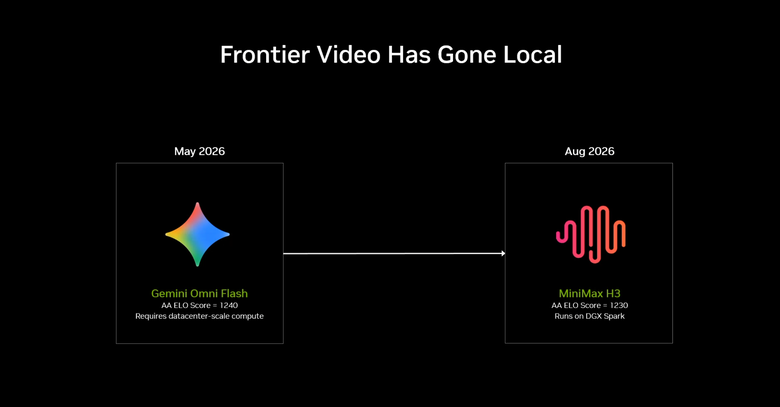
而在生成式 AI 部分也出現同樣的趨勢,今年 5 月 Google 才推出 Omni Flash 模型,而到 8 月份就有像是 Minimax H3 這樣可以提供接近品質輸出的地端模型出現,讓內容創作者可以透過地端裝置生成內容,不用受到雲端平台 Token 數量的限制。
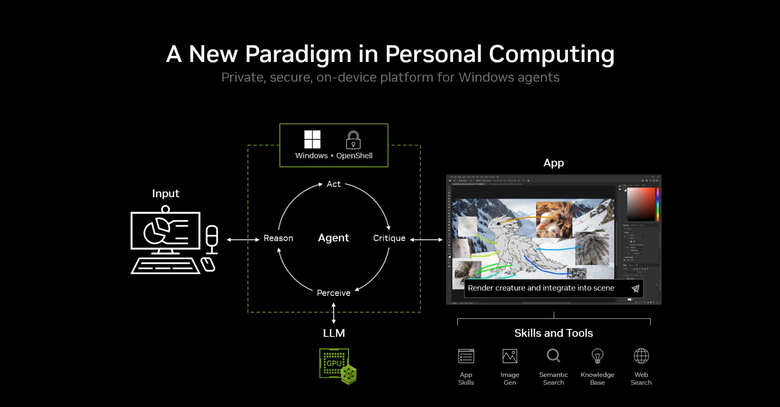
而這個狀況也開始改變了人們使用 PC 的方式,在過去人們需要學習怎麼利用應用程式來在 PC 上面工作,而到在 AI 代理加入後,則變成了人類定義出工作的內容之後,AI 代理找出方法去完成這項工作。人類可以利用文字、聲音來輸入指令,AI 代理就會理解指令並且啟動應用程式進行作業,也就是目前大家所說的 Skills 或是 AI 工具,而 NVIDIA 也與微軟在這邊合作,推出了 OpenShell with MXC(Microsoft Execution Containers,微軟執行容器),讓 AI 代理在可規範的區域內作業,而 NVIDIA 這次也跟目前多個主流的 AI 代理應用合作,提供了在 PC 上更好架設/使用 AI 的方式。
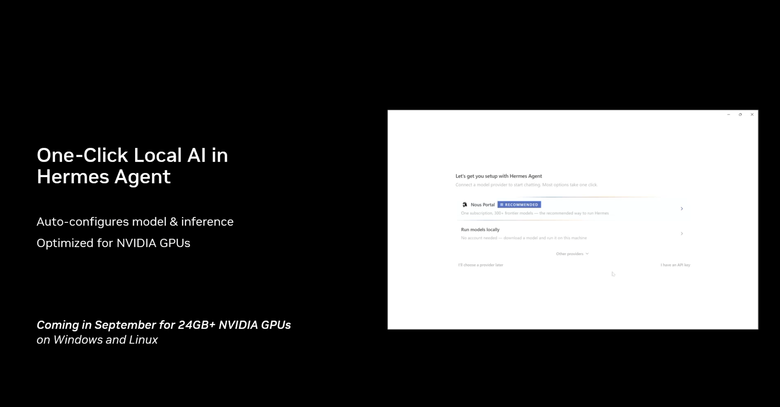
在過去要在自己的 PC 上執行 AI 真的是一項不簡單的任務,要找到適合自己的 AI 模型,然後下載、設定、如果使用多個模型的話還要進行管理,更別提安全性這回事,而這次 NVIDIA 幫你搞定了上面這些麻煩事,跟目前主流的 Hermes Agent 合作,推出了一鍵下載/自動設定 AI 模型的服務,只要在 Hermes Agent 上面選擇自己想要使用的模型,就可以透過 Hermes Agent 直接進行自動下載/安裝/設定的工作,並且針對 NVIDIA GPU 進行最佳化,支援 24GB 以上記憶體配置的 NVIDIA GPU,將在 9 月份推出 Windows 與 Linux 作業系統適用的 App。
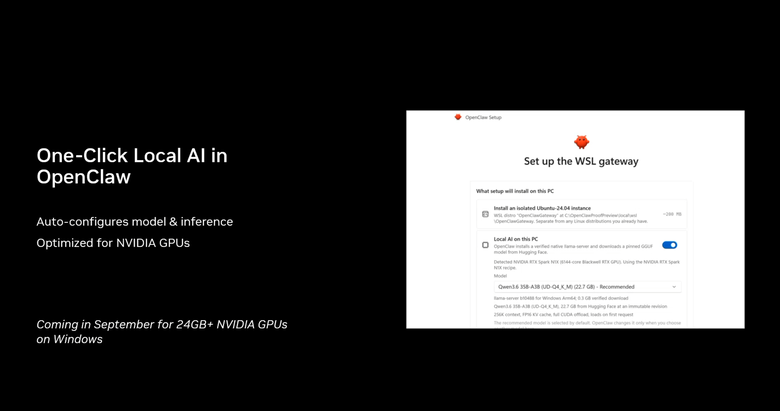
另外一個相當知名的 AI 代理 Open Claw 也在先前推出了 2.0 版本,NVIDIA 也一樣推出了 Windows 版本的 App,提供了依照使用者需求自動選擇/設定模型的功能,並且針對 NVIDIA 的 GPU 進行最佳化設定,而且也是一鍵完成,將在這個月稍晚開放。
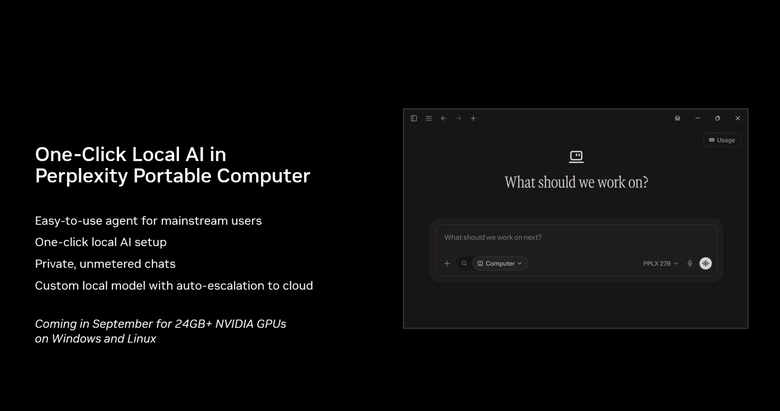
而許多人使用的 Perplexity AI 搜尋/解答工具也在 8 月份,針對 DGX Spark 平台推出了地端的 Perplexity Portable Computer 版本,除了同樣具備一鍵安裝/設定的簡單操作特性外,也可以讓使用者在地端/雲端,依照工作負載的複雜度進行工作運算的切換,而在這次的發表中,也針對 RTX GPU 推出了 Windows 以及 Linux 版本,提供使用者在本地端不受 Token 數量限制、具備隱私保護以及更簡單的操作使用體驗。
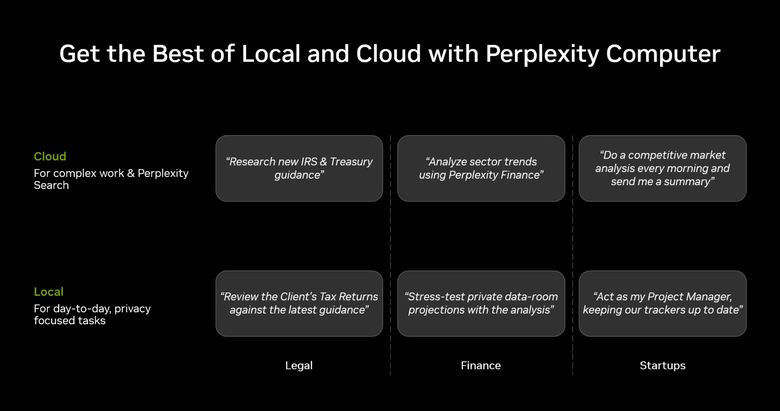
這張圖是 Perplexity Portable Computer 針對不同類型的工作在雲端與地端工作的分級,可以看到雲端運算負責處理比較複雜的工作(像是研究最新的稅務條款),而地端則是負責日常/注重隱私保護的工作內容(針對敏感客戶資資料進行運算),可說是目前雲端/地端協作的理想模式。
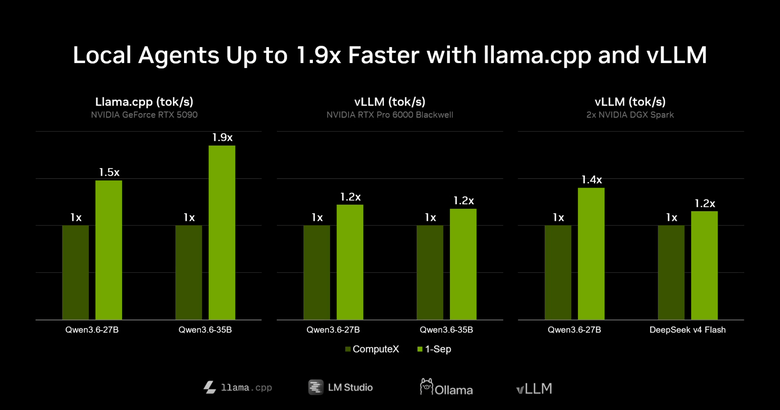
而 AI 代理也越來越聰明與易用,NVIDIA 也跟 VLLM 以及 llama CPP開源社群合作,持續提升 AI 代理在 NVIDIA 硬體上面的效能,可以看到跟 Computex 時相比,僅僅 3 個月,到 9 月初都有相當顯著的效能提升。
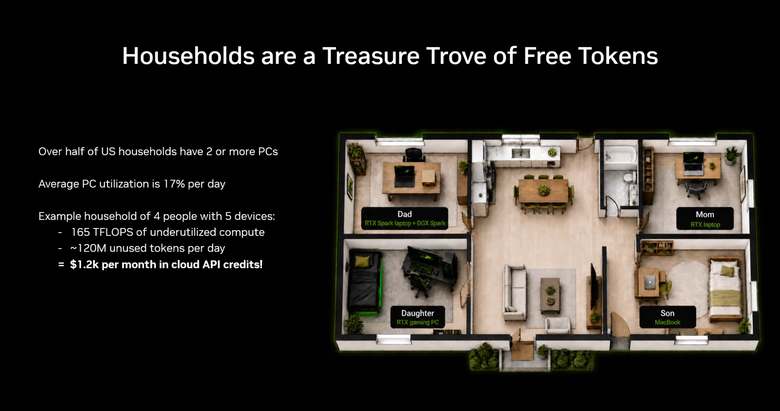
而有了強大的模型與執行工具後,足夠的平台算力變成是在地端執行 AI 的另一個瓶頸點(加上現在記憶體那麼貴.....),要打造一個可以運作地端 AI 的裝置成本真的不低,但單一裝置不行,如果多個裝置一起協作呢?所以 NVIDIA 在這次把腦筋動到家裡的各台 PC 上,NVIDIA 在簡報裡表示,目前有半數的美國家庭擁有兩台或是以上的 PC,而這些 PC 平均每天的使用量僅有 17%(大概是 4 小時多一點),以一家四口五台裝置為例,總共會有 165 TFLOP 的算力,相當於 120M 的 Token 量(以 QWen 3.8 27B 模型來算)是被浪費掉的,換算成雲端 AI 服務的費用,每月大約是 1200 美元左右(有這麼多?!)
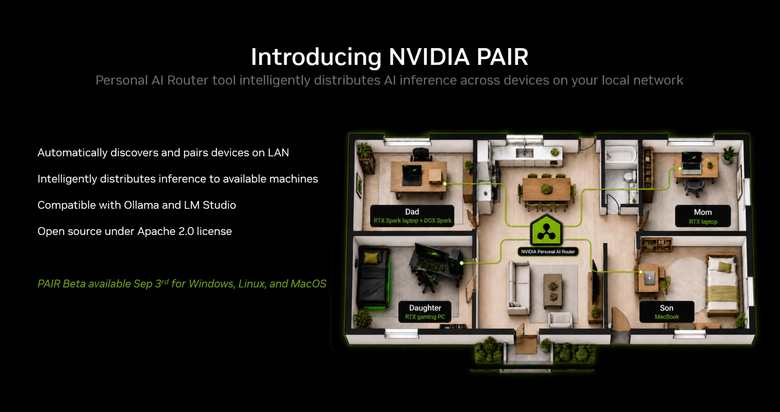
所以為了要使用這些被浪費的算力,NVIDIA 這次推出了一個叫做 NVIDIA PAIR 的個人 AI 路由軟體,可以在家庭區域網路內智慧分配 AI 推論工作給各個裝置,一起完成 AI 負載任務。NVIDIA PAIR 會使用 MDNS 技術進行自動搜尋,並且透過 6 位數字密碼配對區域網路裡面的裝置,建立具備安全性的 MTLS 通道,將推論工作智慧分配給可用的裝置,目前可以相容於 Ollama 以及 LM Studio 工具,支援包括 Windows、Linux 以及 MacOS 作業系統。
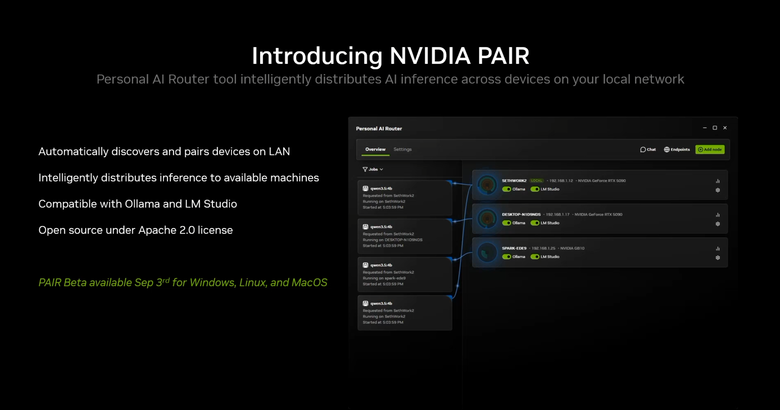
在安裝完成之後,NVIDIA PAIR 會根據目前連接裝置的狀況(比如說是閒置或是正在工作、玩遊戲)來動態分配推論工作,工作的原理是透過類似代理 Proxy 的方式,直接接管了 Ollama 或是 LM Studio 的 Port,讓 AI 代理以為仍然與 Ollama 或是 LM Studio 進行溝通,但背後 NVIDIA PAIR 則是將推論工作分配到不同裝置上,以個別 Instance 進行運作, AI 代理不需要進行工作分配或是整合運算結果,減少 AI 代理的運算。
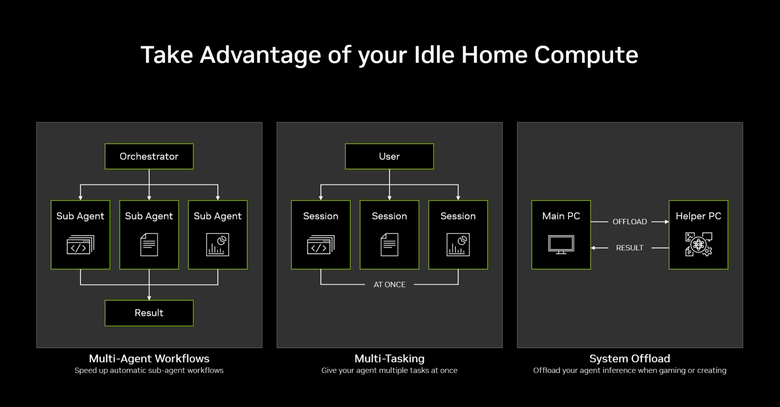 NVIDIA 在簡報中展示了三種不同最常使用的情境,最左邊的是多個 AI 代理進行協作,有一個主代理進行策劃者(Orchestrator)的角色,指揮多個副代理進行不同的作業,最後整合產出結果。第二個中間的情境則是多工作業,一個代理同時進行多項作業,NVIDIA PAIR 在這個地方可以把工作 Session 分給不同電腦加速作業。第三個最右邊的情境就是將推論作業交給其他閒置的電腦處理,當主電腦要用來玩遊戲或是進行內容創作等工作時,NVIDIA PAIR 可以將推論工作轉移到其他 PC 上持續作業。
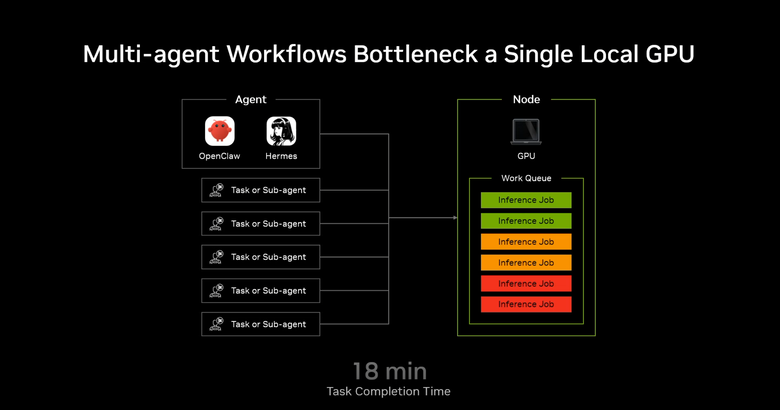
而更詳細的來看第一個多個 AI 代理同時進行作業的情境,上圖是在同一台電腦(同一個節點)進行運算的情形,雖然是有多個 Sub Agent 進行作業,但是受到工作排程的影響,需要等上一個推論作業完成才能進行下一個。
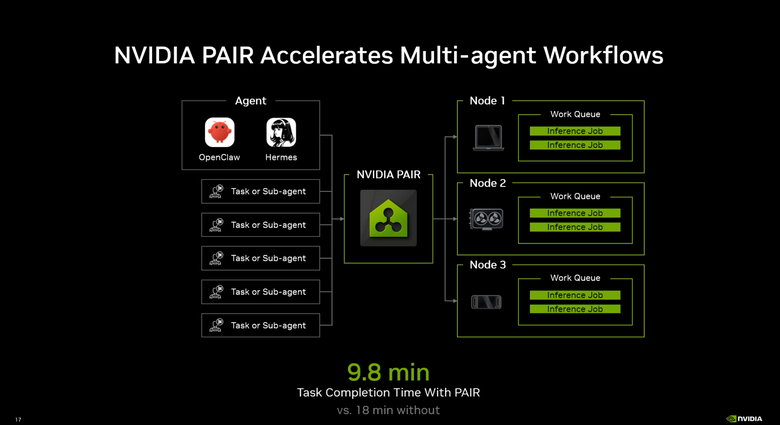
而在 NVIDIA PAIR 上頭,可將推論作業分散到不同節點進行運算,跟上圖相比節省了幾乎一半的時間。
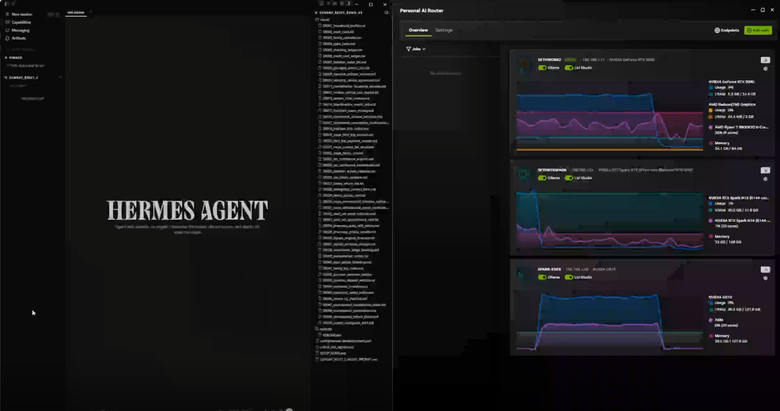
NVIDIA 在簡報中也以 HERMES Agent 這個代理工具進行示範在不同機器組成的群組進行多代理運算的情形。NVIDIA PAIR 的 Beta 版本將在 9 月 3 日釋出。
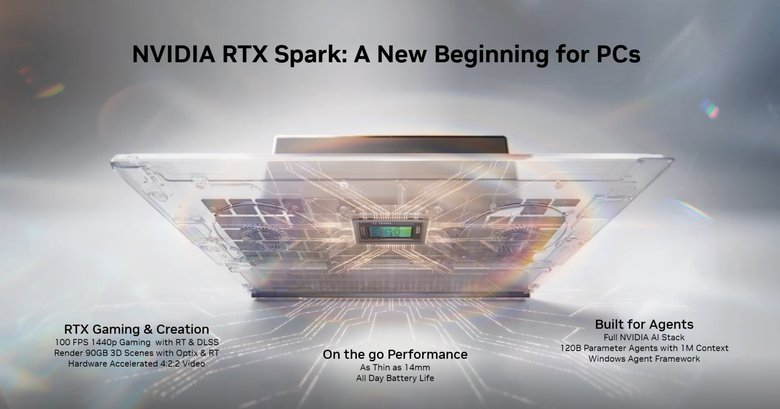
接著談到在 Computex 登場的 RTX Spark,在 1.4 公分的輕薄機身內,具備了 RTX 顯示卡的遊戲與內容創作效能,另外也完整支援 NVIDIA AI 軟體架構,可以運作 120B 參數量/1M 上下文長度的 AI 代理,並且支援 Windows 代理框架。
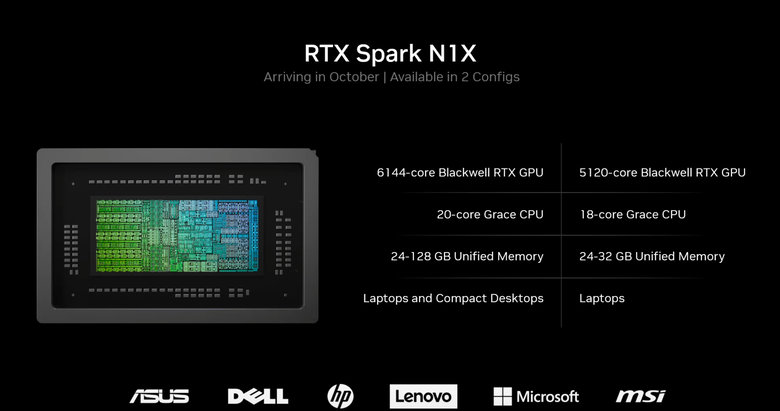
而在 RTX Spark 產品裡,首發的處理器為 Spark N1X 系列,將會有兩個不同規格,高階具備 6144 核心的 Blackwell RTX GPU、20 核心 Grace CPU、24 至 128 GB 統一記憶體、將會有筆電與迷你桌機兩種構型的產品。而另一款則是採用 5120 核心 Blackwell RTX GPU、18 核心 Grace CPU、24 至 32GB 統一記憶體,僅會有筆電產品構型,將會在 10 月份開賣。
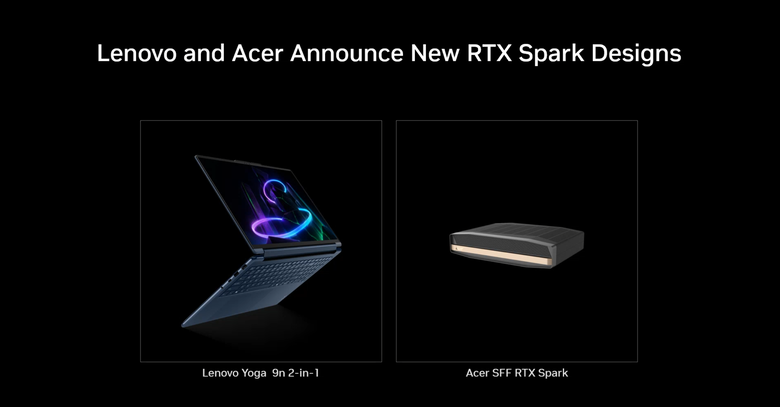
而在這次 IFA 展中,聯想跟 Acer 也發表的新的 RTX Spark 機種,聯想推出的是 Yoga 9n 二合一筆電,而 Acer 則是推出 SFF RTX Spark 迷你桌上型電腦。
當然先前 NVIDIA 一直強調的遊戲支援性,先前在 Gamescom 科隆遊戲展的發表中就有提到,將會有 EA、Ubisoft、Embark 等遊戲發行商提供支援。



 商人的商業藍圖,價格應不便宜,不知何時能普及平民化讓大家用的起和模型不會過時。猜想應該未來會賣模型