MinMaxH3是2026/8剛開源的多模態模型。
comfyui 更新到0.32.0(2026/8/13發布),可以避免int8模型讓GPU崩潰。
測試10秒,解析度0.4:864*480,PASS:計算時間約15分鐘
測試15秒,解析度0.4:864*480,PASS:計算時間約30分鐘

以下為硬體資源能耗程度:DDR5 256GB(6000MT/s)、RTX5060ti 16GB
0.4的解析度RAM已經用了110GB
如果解析度720P,0.9:1280*736,可能會超過200GB
提供正想要在本地運行comfyui的同好參考!
[提醒]:bf16模型,以上硬體無法運行,不用花時間下40GB的模型!!

可能有人會問這是甚麼,這就是海螺3本地部屬版本,與線上差別就是無審察...
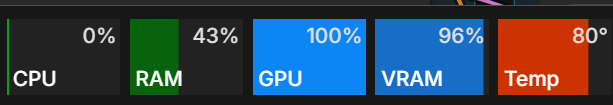

MinMaxH3硬體能耗分享
RTX 3060跑 720X480 8秒要 6分鐘.. 拉長到12秒要10分鐘..

用了4步L0RA加速跑6步, sageattention加速還沒試.

原來H3叫海螺3.. 去年海螺免費試用有跑幾個影片.
MinMaxH3 是第一個不可以在美國、英國、歐盟、韓國使用的生成模型,要用需要去申請,因為去年9月迪士尼、華納、環球去告海螺,所以禁止這些地方使用
blueled
道理很簡單,能畫米老鼠的一律禁用
neo6688
反了,是中國模型不讓美國人用,不是被禁用,除了美、英、歐、韓,其他地區都可免費使用
使用模型 (超硬底)
unet minimax_h3_fl2va_pruned_bf16.safetensors 37.4 GB
clip qwen3vl_32b_minimax_h3_bf16.safetensors 47.9 GB
vae minimax_h3_video_vae_fp16.safetensors 4.84 GB
audio minimax_h3_audio_vae_fp32.safetensors 577 MB
共 90.71 GB

DDR5 128GB / AMD RT9060XT 16GB
使用官方 文生影片工作流 無優化
0.4 / 15步 / 生成10秒 / 51分鐘
GPU 使用 15.1 GB / 溫度 57度
DRAM 最高(幾秒)到達 128GB,其餘時間 69GB
總功耗平均約 250W

#### 自行優化後生成時間減少成 24 分鐘 (質感不變)

不是不能運行,要看軟硬體配置是否穩當,雖然沒有 CUDA 加持,至少能省電運行
雖然時間長,還好同時還能上上網看看劇


AMD 顯卡宿命 ~ CUDA 無用,所以只能使用 bf16/fp16/fp32/gguf,盡量不用 fp8/int8,禁止使用 nvfp4
neo6688
大部分的情況 bf16 跟 int8 解讀的文本編碼差不多,而是步數上15步對原始模型來說太少,不是 qwen上的問題,ComfyUI也有內建 qwen VL 的反推工作流,可以去試試怎麼給提示詞
chiafeng
整個流程不變,只更換 int8 -> bf16,我嘗試很多遍,成品 bf16 比 int8 好太多了,不過 bf16 更費時
RunningHub 上用 8 步 LoRA 5秒差不多是 2:32 的生成時間(800 * 1056),花 RH 幣 31 個

用他們最入門的儲值 18000 RH幣 9.9 美元,大概是台幣 330 元左右可出 170 分鐘的影片

會比自己電腦跑省下很多錢
neo6688 wrote:
RunningHub...(恕刪)


沒設備的花點錢在線上生成確實比較省時省錢,但是地端生成有地端生成的優點。
如果能使用登記的模型或是無審查的模型,樂趣無限!
neo6688
RunningHub 用的模型跟自己下載的一樣,工作流上傳就能跑,不是那種只能跑某些現成的網站,就純用別人電腦計算的概念,其他製作都跟本地一樣
在這邊回覆一些問題
並不是所有流程的RAM使用量都一樣
首幀或首尾幀這些單純工作流64GB RAM + 16GB VRAM就可以玩了

目前有個很熱的Scail-2
基於WAN2.1架構,其缺點相當明顯,有玩過WAN2.1/2.2就知道

MMH3 R2V加上參考圖、參考視頻、參考音頻、...
Scail-2的缺點都改善了,而且還會對口型唱歌,甚至還可以...mosaic

MMH3有玩到這邊的網友就知道128GB RAM瞬間被抽乾
如果又不是5090、4090這種卡,那速度真的很
chiafeng
只要模型大小能整個放進顯存,速度一定是飛的。像樓主你有 256GB 主記憶體,沒有搭配至少 32GB 顯卡,真是可惜了 !
如果用 ComfyUI 內建的 MiniMax H3 節點,我的電腦 32G + 5060ti 16G 就能跑了,這是因為 ComfyUI 本身會自動調整記憶體,記憶體多就會用的多

通常會有記憶體不夠的,大部分是第三方節點跑的,因為這些節點比較難接入到 ComfyUI 的記憶體管理中

除非可用的 RAM, VRAM 低到一個沒辦法調度的狀況,不然 ComfyUI 內建的很少會出現記憶體不足

速度其實還是看顯卡
用 5060TI 做標準,假如 10 分鐘跑完
4090 會快 3 倍左右,大概 3 分多(10分鐘除3)
5090 會快 4 倍左右,大概 2 分多(10分鐘除4)

3060, RT9060XT 跟 5060TI 差多少我沒概念,9060XT 應該跟 5060TI 差不多

Qwen VL 文本視覺模型,只有在跑工作流時前幾分鐘會執行,一旦跑到採樣器時,運作的是H3本身模型,所以 QwenVL 會給記憶體加載,沒用時就會釋放掉非必要的,就是記憶體用量下降那段。

不過記憶體大,預設Qwen 加載的就多,解讀提示詞上成功率會高一些,但有時運氣好時也可能一次就達標。其中關鍵是提示詞寫得有沒有到位,提示詞寫得好理解,Qwen 瞎猜的機率就小,所以記憶體少的,就要把提示詞寫好一點
ComfyUI 生成時記憶體不足是會跟SSD借容量,但是沒設定好就會直接崩潰,本人就發生過一次,衝破 128GB 幾秒後就重新開機

不過模型載來載去,快取借來借去傷的都是SSD,所以一次載入生成是最好選擇

AI 生成確實是看顯卡及顯存
想要速度一定要選 Nvidia 不要選 AMD
目前 AI 生態全支援 CUDA,即使 AMD 有 ROCm ,整體上還是輸,唯一優點大概就是省錢(便宜與功耗較低)

所以模型能全載入顯卡生成的都用秒來算,模型超過顯卡容量就必須用到 DRAM,搬來搬去耗很多時間

所以 Nvidia 算準這點,32GB 以上的都必須花 6 位數的錢
小弟是有用projection的方式把text encoder映射到Qwen3VL 8B,然後主模型用未剪枝的INT8,也不曉得該重視哪一邊就是了⋯⋯(5090m 24g + 64gDDR5)
關閉廣告
文章分享
評分
評分
複製連結

今日熱門文章 網友點擊推薦!